こんにちは、タイミーでバックエンドエンジニアをしている志賀(@akitoshiga)です。
先日、複数の顧客企業にまたがる、複雑なデータ統合プロジェクトに取り組みました。
このプロジェクトには、次のような難しさがありました。
- 要件が曖昧で、影響範囲も見えづらい
- 統合パターンごとに状況や制約が異なり、考慮すべき条件が多い
- 関係者が多く、合意形成に時間がかかりやすい
- 事業上、変更しづらい期限がある
- 当時の体制では、バックエンド領域を主担当として動けるメンバーが限られていた
このまま進めるだけでは、期限内の完了が難しい状況でした。
結論から言うと、次の3つを実践することで、期限内に完了できました。
- AIを使ってコードと業務を調査し、自分で判断できるメンタルモデルを作った
- AI-DLCを使い、主担当領域の異なるメンバーも実装を進められる状態を作った
- ドキュメントを通じて論点を絞り、関係者の認知負荷を下げた
本記事では、この取り組みを紹介します。
プロジェクトの概要
タイミーでは、契約・請求・拠点・アカウント・アクセス権限など、複数の業務データが企業情報と結びついています。
データ統合は、単に参照先を変更するだけでは終わりません。
統合後にどのような状態であるべきかを定義し、その状態に合わせて関連データを整合させる必要があります。
今回のプロジェクトでは、統合パターンごとに移行範囲や制約が異なりました。
そのため、対象データごとに「何を移すのか」「何を残すのか」「どの状態を正とするのか」を判断する必要がありました。
複雑な統合パターンの存在
実案件を抽象化すると、次のような関係でした。
- ある統合元は、すべての拠点を統合先へ移す
- 別の統合元は、一部の拠点だけを統合先へ移す
- さらに別の統合元は、別の企業へすべての拠点を移す
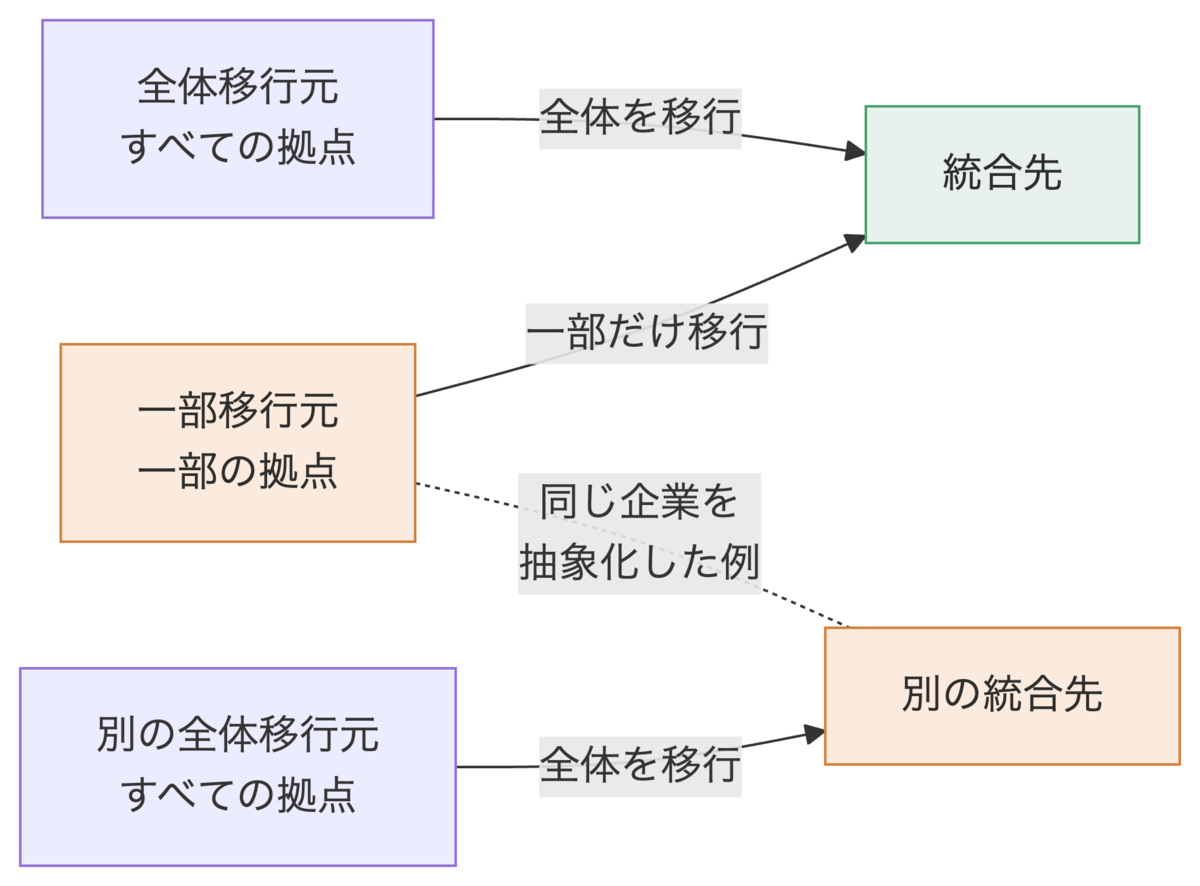
この図は、実案件を説明用に抽象化・簡略化したモデルです。
ポイントは、同じ対象が、ある統合では移行元になり、別の統合では移行先にもなることです。
そのため、すべてのデータを一律に移すことはできません。
残すデータと移すデータを、対象範囲ごとに判定することが求められました。
また、別の統合によって入ってくるデータも考慮する必要がありました。
そのため、統合の実行順序にも依存関係が生まれました。
アクセス権限の組み合わせ爆発
顧客に紐づく各種データについても、場合分けが必要でした。
その一例が、管理画面アカウントとアクセス権限です。
アクセス権限には、全体に関わるものと、一部の範囲に関わるものがあります。
移行後も、本来アクセスできない範囲へ権限が広がってはいけません。
一方で、移行前に必要だった範囲へのアクセスを失わせることもできません。
この両立が、難しいポイントでした。
権限の種類、移行範囲、統合パターンの組み合わせによって、望ましい状態が変わるためです。
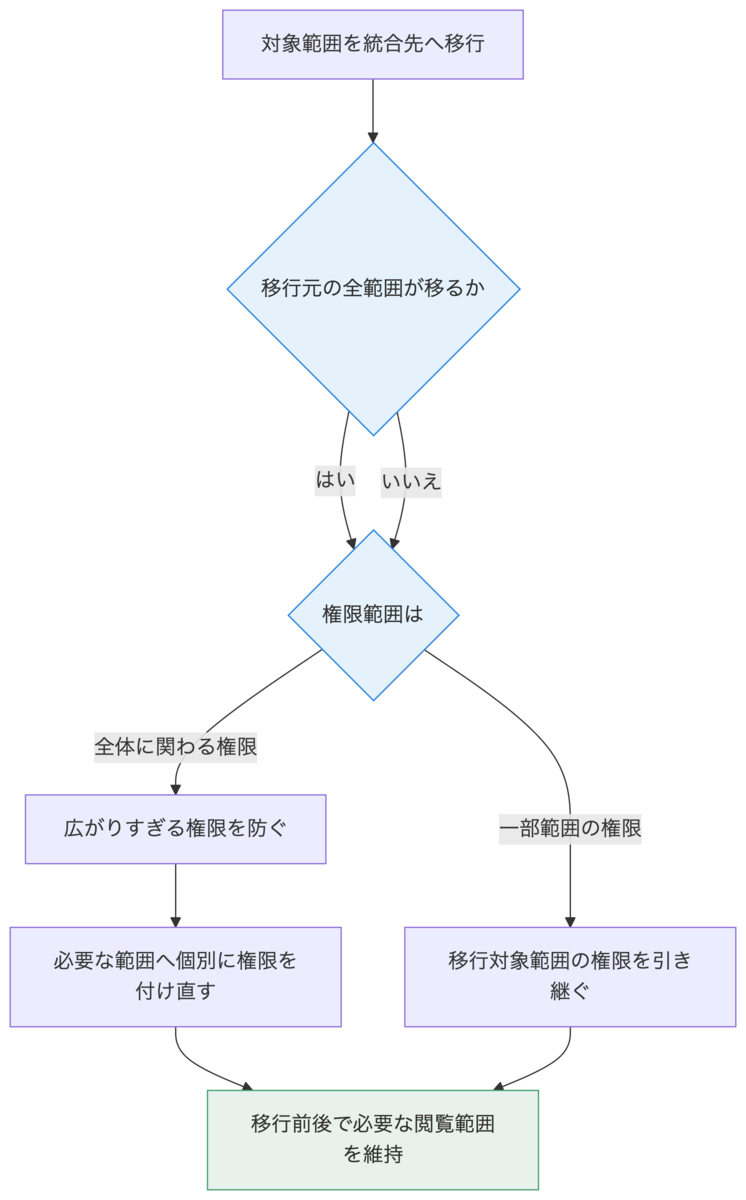
関連データごと種類ごとにこれらの判断が必要になる
他のデータも同様でした。
統合パターン、移行範囲、状態、関連データの制約が組み合わさり、判断すべき条件が増えていました。
自分は、関連するすべてのドメインに詳しいわけではありませんでした。
影響範囲を把握し、統合後の状態を決めるには、まず調査が必要でした。
どう進めたか
AIを使って調査し、メンタルモデルを作る
まず、AIを使ってコードを解析しました。
そのうえで、実際に画面を操作し、コード・画面・データの対応関係を確認しました。
自分の中でメンタルモデルを作れるまで、時間をかけて調査・検証しました。
前例がなく、自分たちで統合後の正しい状態を定義する必要があったためです。
ここで言うメンタルモデルとは、次のようなものです。
- どのデータが、どの業務概念を表しているか
- どの操作で、どのデータが変わるか
- 統合後に、何が変わってはいけないか
- 異常系や例外パターンで、どこに影響が出るか
この理解をもとに、PdMや関係者と相談しながら統合仕様を決めていきました。
短納期とチーム構成を踏まえてAI-DLCを採用する
データ統合には、バックエンドのフレームワーク上で動作するスクリプトの実装が必要でした。
一方で、変更しづらい期限がありました。
自分だけで進めるには、時間的な制約が大きい状況でした。
そこで、主担当領域の異なるメンバーと一緒に進めるため、AI-DLCを採用しました。
AI-DLC(AI-Driven Development Life Cycle)とは、AWSが提唱するAIを中心に据えた開発手法です。
要件整理、計画、設計、実装、テスト、運用まで、開発ライフサイクル全体にAIを組み込んでプロジェクトを進めます。
タイミーでは、以前AI-DLCを業務で活用するための合宿を実施しました。
3日間のUnicorn Gymが1ヶ月で組織を変えた —— データで見るAI-DLC導入の波及効果 - Timee Product Team Blog
今回は詳細設計までを、複数人でAIの出力を確認するモブワークで進めました。
実装に必要な前提と完了条件を共有した後は、主担当領域の異なるメンバーにも、非同期で実装を進めてもらいました。
AIを使うことで、バックエンドの文法や実装パターンの理解を補助できます。
ただし、仕様の正しさまでAIに任せることはできません。
そのため、前提・制約・完了条件を人間が明確にしました。
そのうえで、AIの出力をレビューできる状態を作ることを重視しました。
合意のための認知負荷を下げる
このプロジェクトは影響範囲が広く、多様な関係者が関わっていました。
全員に統合仕様のすべてを理解してもらおうとすると、合意までに時間がかかります。
また、関係者がそれぞれ判断すべきポイントも異なります。
そこで、意思決定のためのADR(Architecture Decision Record)では、必要な論点を絞りました。
レビュー観点、選択肢、推奨方針、影響、リスクを整理しました。
関係者が、それぞれの判断範囲に集中できるようにするためです。
仕様を説明・相談する際にも、認知負荷を下げるためのドキュメントを用意しました。
具体的な手法はここでは割愛しますが、以下の書籍を読んだ経験が自分の中で大きな礎となっています。
- 『ノンデザイナーズ・デザインブック』
- 『プログラマー脳』
- 『実装パターン』
その取り組みの結果、短いリードタイムで方針への合意を得られました。
終盤の考慮漏れに向き合う
仕様が複雑だったため、終盤のテスト工程で考慮漏れが見つかりました。
また、終盤で体制変更があり、権限に関する仕様判断を自分が引き取る必要がありました。
ただし、序盤にメンタルモデルを作っていたため、どこを確認し、誰に相談し、どの制約を守るべきかを自分で判断できる状態になっていました。
追加対応は発生しました。
それでも、影響範囲を絞り、対応順を決め、関係者と優先度を確認し、期限内に実装とテストを終えることができました。
まとめ
約1か月半という短い期間かつ限られた体制で、前例のない複雑なデータ統合プロジェクトに取り組みました。
この状況に対して、次の3つを実践しました。
- AIを使ってコードと業務を調査し、自分で判断できるメンタルモデルを作った
- AI-DLCを使い、主担当領域の異なるメンバーも実装を進められる状態を作った
- ドキュメントを通じて論点を絞り、関係者の認知負荷と合意形成のリードタイムを下げた
結果として、複数のメンバーで実装を分担し、期限内に実装とテストを完了できました。
一方で、AI-DLCを使っても、仕様の正しさまで保証されるわけではありません。
前提となるドメイン理解と、人間による意思決定が重要です。
AIは、単なるコード生成ツールではありません。
理解・合意・協働を加速する存在として開発プロセスに組み込むこと。
それが、AI時代のプロダクトエンジニアリングに必要な姿勢だと感じました。
